vLLM 0.14 框架梳理:调度、内存管理与计算
这是 vLLM 0.14 源码梳理的第一部分,聚焦三件事:请求如何被调度、KV Cache 如何被管理、以及这些数据最终在计算时如何被使用。
一、请求如何进入 EngineCore
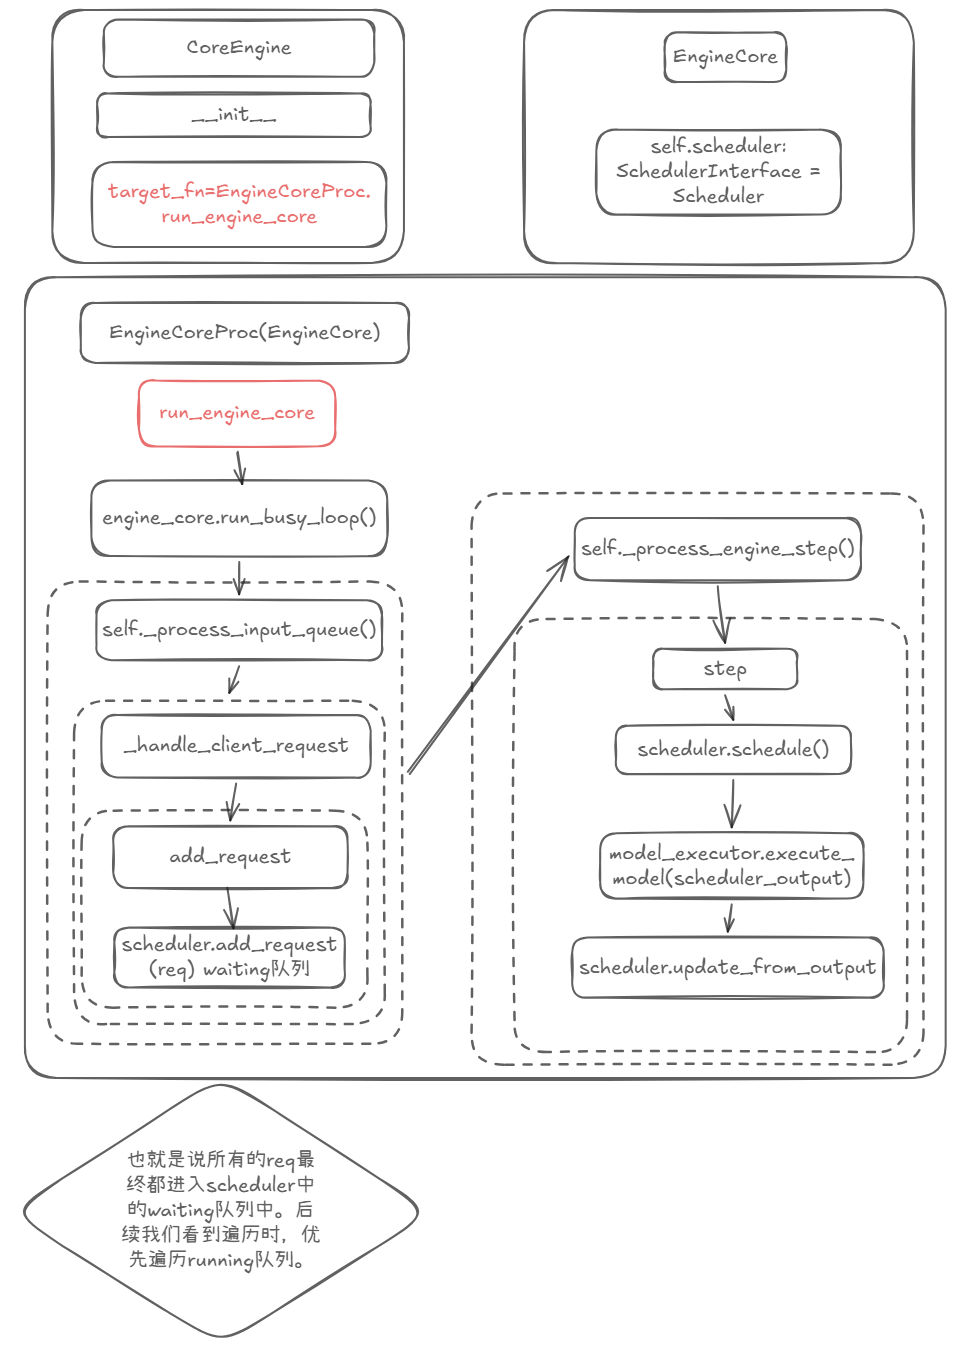
接上一章,req 进入到 EngineCoreProc 之后,有一个 CoreEngine 类在他的 __init__ 函数中会调用 target_fn = EngineCoreProc.run_engine_core,而这个函数就是 EngineCoreProc(EngineCore) 中的 run_engine_core,最终的效果就是调用 scheduler.add_request(req) 加入 waiting 队列。
涉及文件:
core_client.py、core.py
二、每一步 step 在做什么
接下来是关于 engine 的 step,每一步 step 都是:
scheduler.schedule() + model_executor.execute_model(scheduler_output) + scheduler.update_from_output
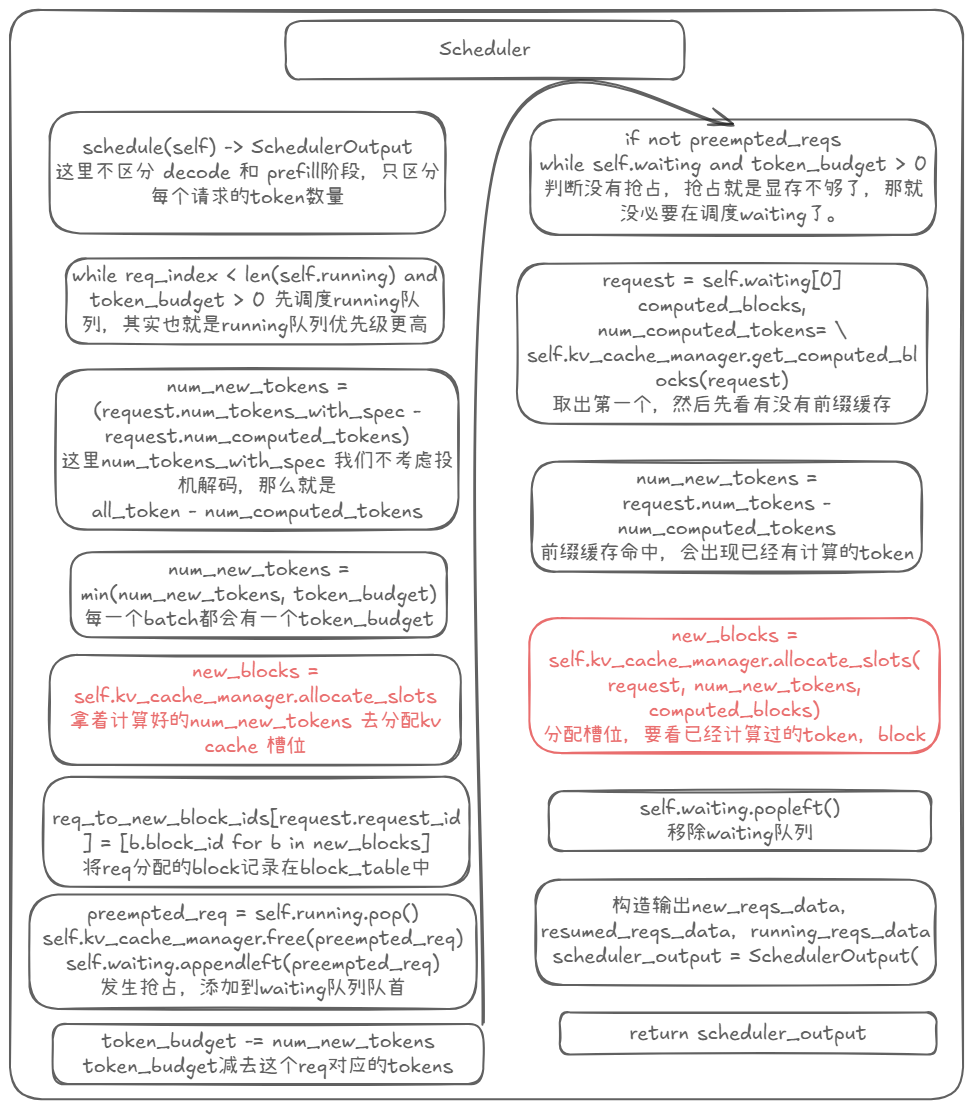
如图二,schedule() 函数就是在调度 Scheduler 这个类中 waiting、running 两个 req 队列。waiting 队列就是还没有分配 KV Cache 的(包含被抢占的),running 就是已经被分配了 KV Cache 的。
先调度 running 队列(优先级更高),然后取出第一个 req,计算这个 req 当前 step 需要多少新 token:如果是 decode 就是 1(假设不开启投机解码),prefill 就是所有 prompt 的 token。然后用计算出来的 num_new_tokens 去计算需要分配的新的 block:
new_blocks = self.kv_cache_manager.allocate_slots(...)
然后将这个当前 req 新分配的 block 记录在 req_to_new_block_ids,这是一个 dict,记录了每个 req 当前 step 的 block。
如果在 running 过程中发生抢占,也就是显存不足够分配 new_blocks 了,那么将这个 req 放入 waiting 队列的第一个,并且 free 他所对应的 block。
当 running 队列的 req 调度完成之后,调度 waiting 队列(前提是不发生抢占,抢占时是显存不足了,就没必要再调用 waiting 队列了),也是一样的过程。但 waiting 队列中有一个前缀匹配过程:首先查看当前 waiting 队列的 reqs 的 token_ids 是否与已缓存的 block 完全匹配?如果有匹配我们则会直接使用已匹配 block 的 KV Cache 用来计算,并且 input 变成第一个不匹配 block 的第一个 token。
前缀匹配中不仅是 token_ids 要完全相同,而是要求 hash 值完全相同(没有存满 block_size 不计算 hash),而当前 block 的 hash 计算不仅仅依赖当前 block 的 token_ids,也依赖上一块的 hash。也就是说如果第一个 block 不 match,后续的 token_ids 完全一样也无法匹配。(「你喜不喜欢吃苹果」,「他喜不喜欢吃苹果」,第一个 token 已经不 match,后续全部一样也没用了。)
前缀匹配之后,也是用 num_new_tokens 去计算 new_blocks,然后再记录在 req_to_new_block_ids 中。最后将这些 waiting、running、preempt 的请求打包输出为 scheduler_output = SchedulerOutput()。
涉及文件:
scheduler.py、kv_cache_manager.py
三、block 与 block_table
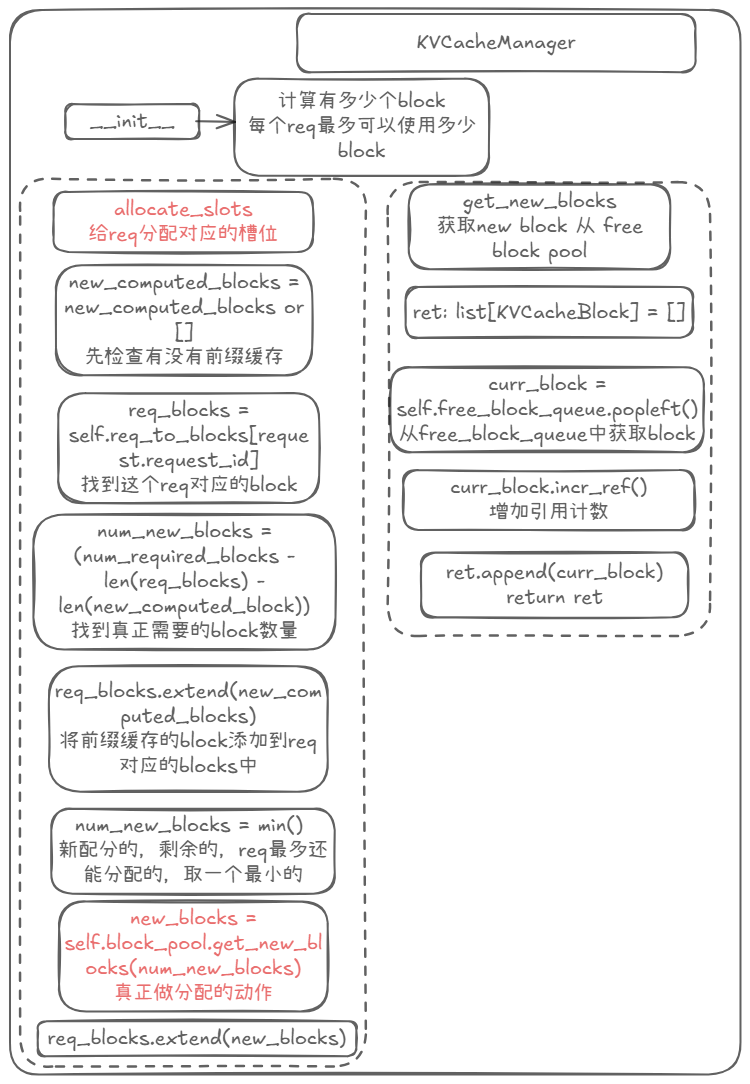
如图三,这一节我们先不讲刚刚打包好的 scheduler_output 会去到哪里,而是详细了解 block、block_table 这些概念。
在刚刚的 schedule 中有使用 allocate_slots 函数,而这个函数就是给 req 的 new_token 分配 block 的函数,然后记录在这个 dict 中 req_blocks.extend(new_blocks),他记录了每个 req 对应了哪个 block!它内部会调用 get_new_blocks 函数真正给这个 req 分配 block。
这里似乎有点问题:这个类负责分配 block,但是 block 从哪里来的我们似乎还是不知道。接下来我们就继续深入。
涉及文件:
kv_cache_manager.py、block_pool.py
四、block 从哪来:KV Cache 的初始化
在 KVCacheManager 的 __init__ 函数中我们发现有这么一个字段:
self.num_gpu_blocks = kv_cache_config.num_blocks
这个表示 GPU 有多少 block,那这个数据又是怎么来的呢?
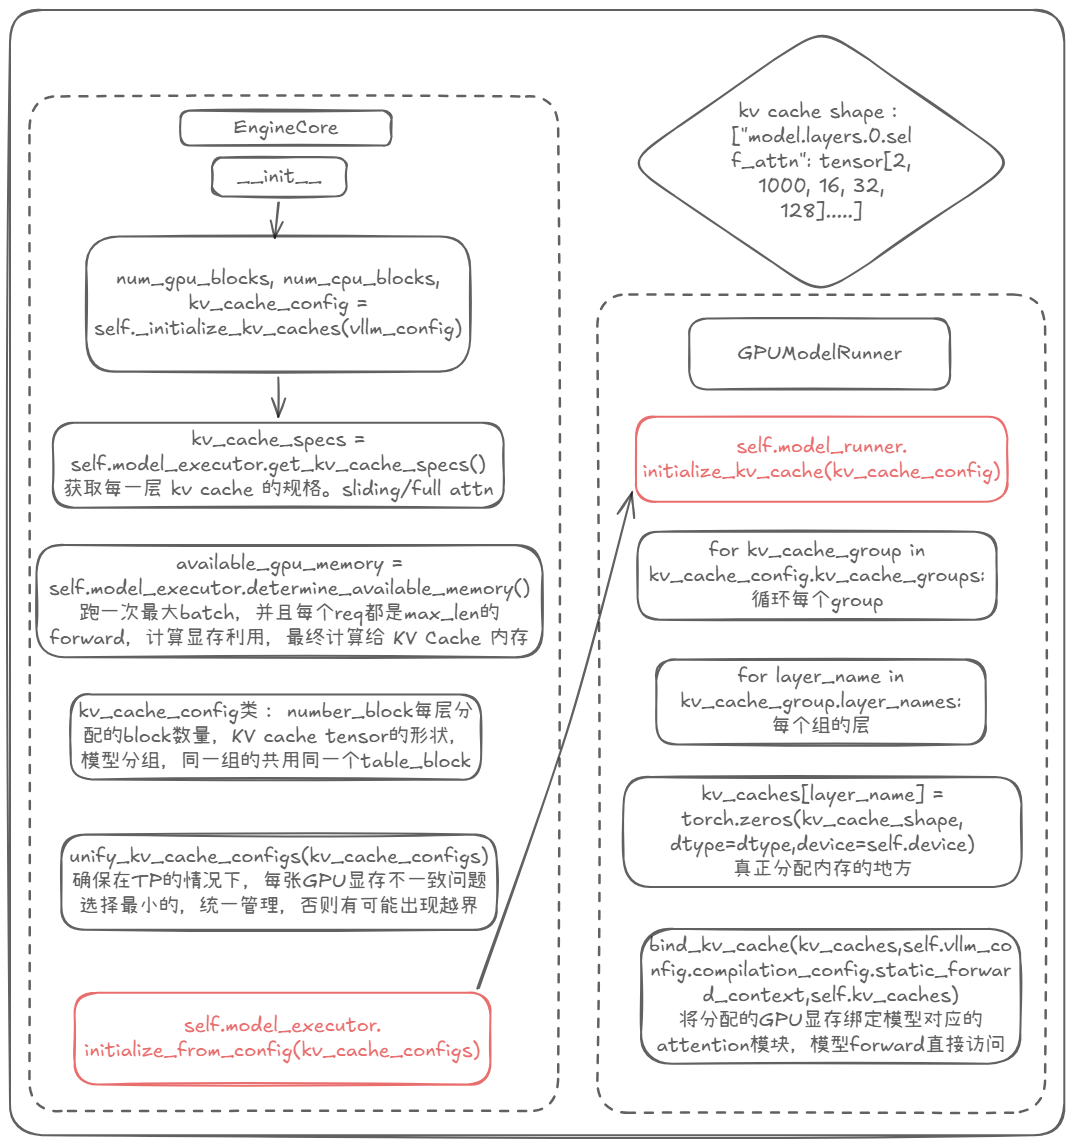
如图四,在 EngineCore 的 __init__ 中,我们发现了一个 _initialize_kv_caches 函数,这个函数首先获取了模型每一层的 attention 的规格 kv_cache_specs(比如是 full 还是 sliding window attn),接下来调用了 model_executor.determine_available_memory() 来获取供给 KV Cache 的空闲的显存 available_gpu_memory。
然后我们用获取的 kv_cache_specs 和 available_gpu_memory 得到了 kv_cache_configs 这个参数,它包含了每层分配的 block 数量、KV Cache tensor 的 shape,也就是这个函数 _get_kv_cache_config_uniform_type——它获取模型层数,计算每层所需的字节大小,并且将规格分 kv_cache_groups;最后调用 self.model_executor.initialize_from_config(kv_cache_configs),将刚刚关于对 KV Cache 的配置描述变成实际的显存!
这个函数中调用:
kv_caches[layer_name] = torch.zeros(kv_cache_shape, dtype=dtype, device=self.device)
也就是先将每层 attention 内存先分配好,后续只需直接使用这个地址读取写入即可。到这里那我们就知道了 KVCacheManager 中的 num_gpu_blocks 是什么了。
关于 KVCacheManager 是如何管理 block 其实就比较简单了,用了一个 BlockPool 类,这个类中有:
self.blocks: list[KVCacheBlock] = [KVCacheBlock(idx) for idx in range(num_gpu_blocks)]
也就是每一个 block 都是一个 KVCacheBlock 对象,然后构建一个 free_block_queue 双向链表管理每个 block。
涉及文件:
kv_cache_utils.py、kv_cache_manager.py、core.py、gpu_model_runner.py、gpu_worker.py、block_pool.py
五、block_table 与 slot_mapping 如何被使用
好的,我们现在已经知道了 block 是怎么来的、怎么管理的,那么它是如何使用的呢?接下来就继续接着 scheduler_output 继续下一步。
在图一中 model_executor.execute_model(scheduler_output) 这个函数使用了 scheduler_output,那我们最终追溯到 GPUModelRunner.execute_model(SchedulerOutput) 这个函数。
这里面涉及 Worker / Executor 的概念,这里就不细讲了。多机多卡情况下,「机」我认为就是 Executor,「卡」就是对应 Worker,Executor / Worker 的通信方式使用共享内存,一写多读,多卡通信方式使用 NCCL,使用 AllReduce 同步——这部分不太了解了。
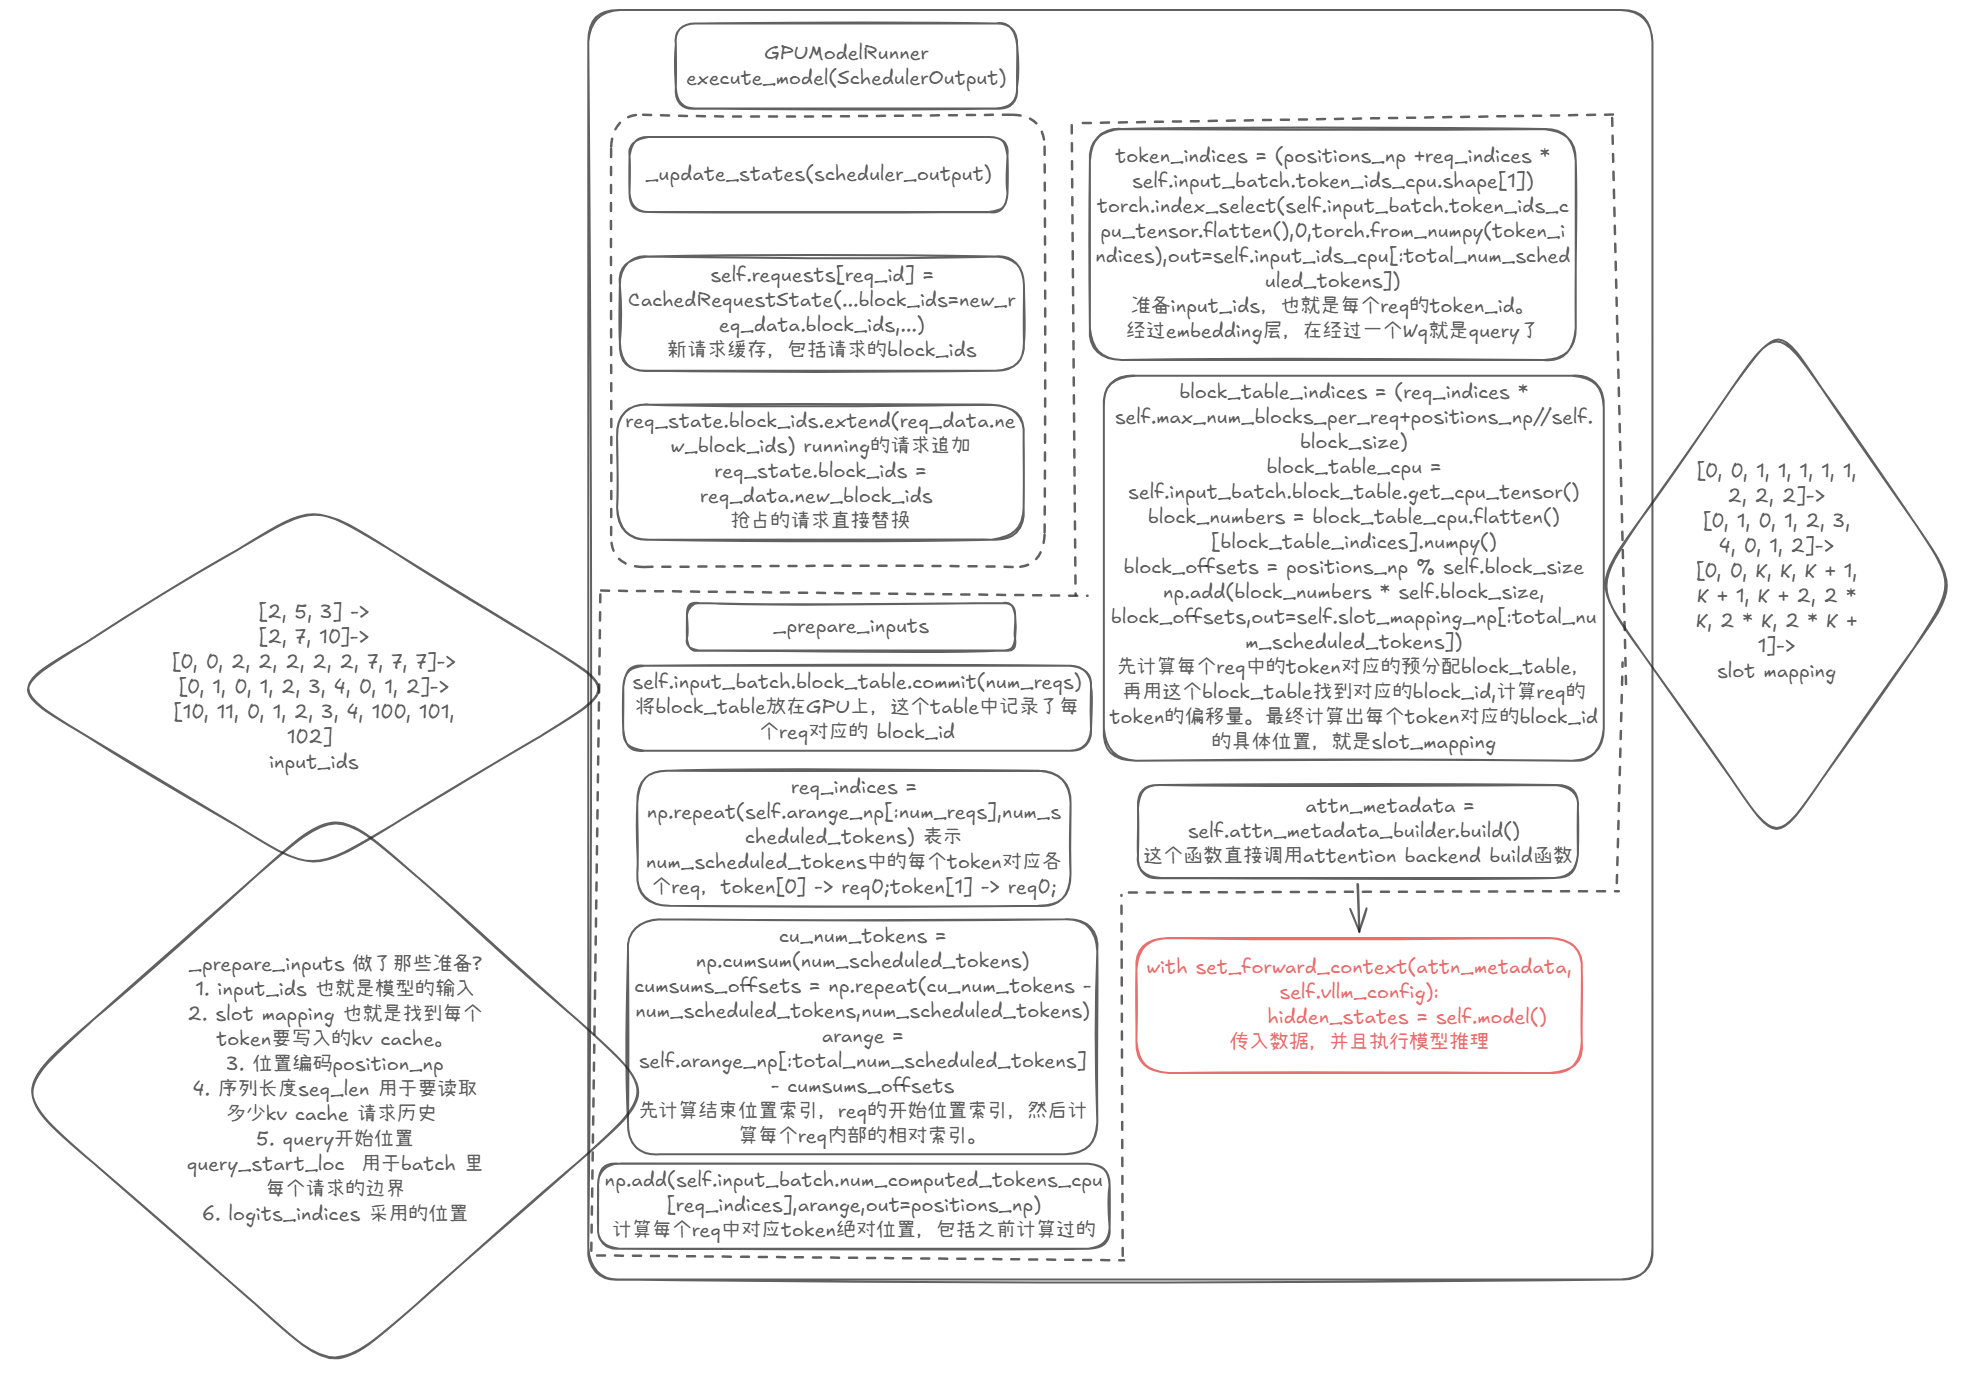
如图五,在模型真正执行 forward 之前还有 _update_states 和 _prepare_inputs 两个函数。这两个函数理解可以比较简单,但是实际逻辑却有点复杂,特别是 _prepare_inputs。
对于 _update_states,我们在图中只写了关于 block_table 部分,其实也就是更新这些 req 的 block_table,因为有可能在当前 step 和上一个 step 调度的 req 有可能完全不同,有可能相同的 req 也添加了 block,有可能有些 req 被抢占了,那么他的 block_table 和上一个 step 完全不同。
对于 _prepare_inputs,也就是准备 forward 函数之前的准备:
首先是关于 input_ids,也就是这一个 step 的 reqs 的 query(当然还需要经过 embedding、Wq 矩阵乘),需要准备好这些 reqs 当前 step 对应的 position 是多少?每个 req 在 input_ids 中对应的范围是多少?整个序列的长度 seq_len 是多少?(读取 KV Cache 用)
还需要准备好 slot_mapping,这个是关于当前 reqs 的 token 对应的 KV Cache 该写入在哪个 block 的哪个槽位。我们用一个例子作为解释:
当前 step 调度 3 个 reqs [2, 5, 3],第一个 req 有 2 个 token,第二个 req 新增 5 个 token,第三个 req 新增 3 个 token,然后变成:
[0, 0, 1, 1, 1, 1, 1, 2, 2, 2]
这种形式,表示 10 个 token,并且 0 就表示 req[0],1 就表示 req[1],2 就表示 req[2],然后再变成:
[0, 1, 0, 1, 2, 3, 4, 0, 1, 2]
表示每个 token 在当前 step 的第几个 token。这里我们假设每个 block_size = 2(每个 block 存储的大小),那么 [0, 1] 对于 req 就可以放入同一个 block 中。并且对于每个 req 都会预分配 max_num_blocks_per_req 这么多个 block(假设这个值为 K),也就是对于 req[1] 的 0, 1, 2, 3, 4 并不是紧挨着 req[0] 的 0, 1 来存储的,他们之间隔了 K 个 block:
[0, 0, K, K, K + 1, K + 1, K + 2, 2 * K, 2 * K, 2 * K + 1]
这样我们就能知道每个 req 的 token 对应的 block_id 是多少了。接下来,我们用刚刚得到绝对位置 position 计算出 offset,这样我们就能知道 req 的 token 对应的 block_numbers * block_size + block_offset,我们就能知道这个 token 具体要写入的具体地址 slot_mapping。
然后将这些数据创建一个 attn_metadata,通过线程局部变量传递给模型,这样就能使用了。
好的,到这 block_table 是如何使用的了,也知道 slot_mapping 是如何计算的了。但是如果我们还想更加深入了解模型到底在哪里用了这些数据,attention 到底如何从中写入或者读取数据?那么接下来我们将了解模型如何执行的。
涉及文件:
gpu_model_runner.py
六、attention 在哪里真正使用 block_table 与 slot_mapping
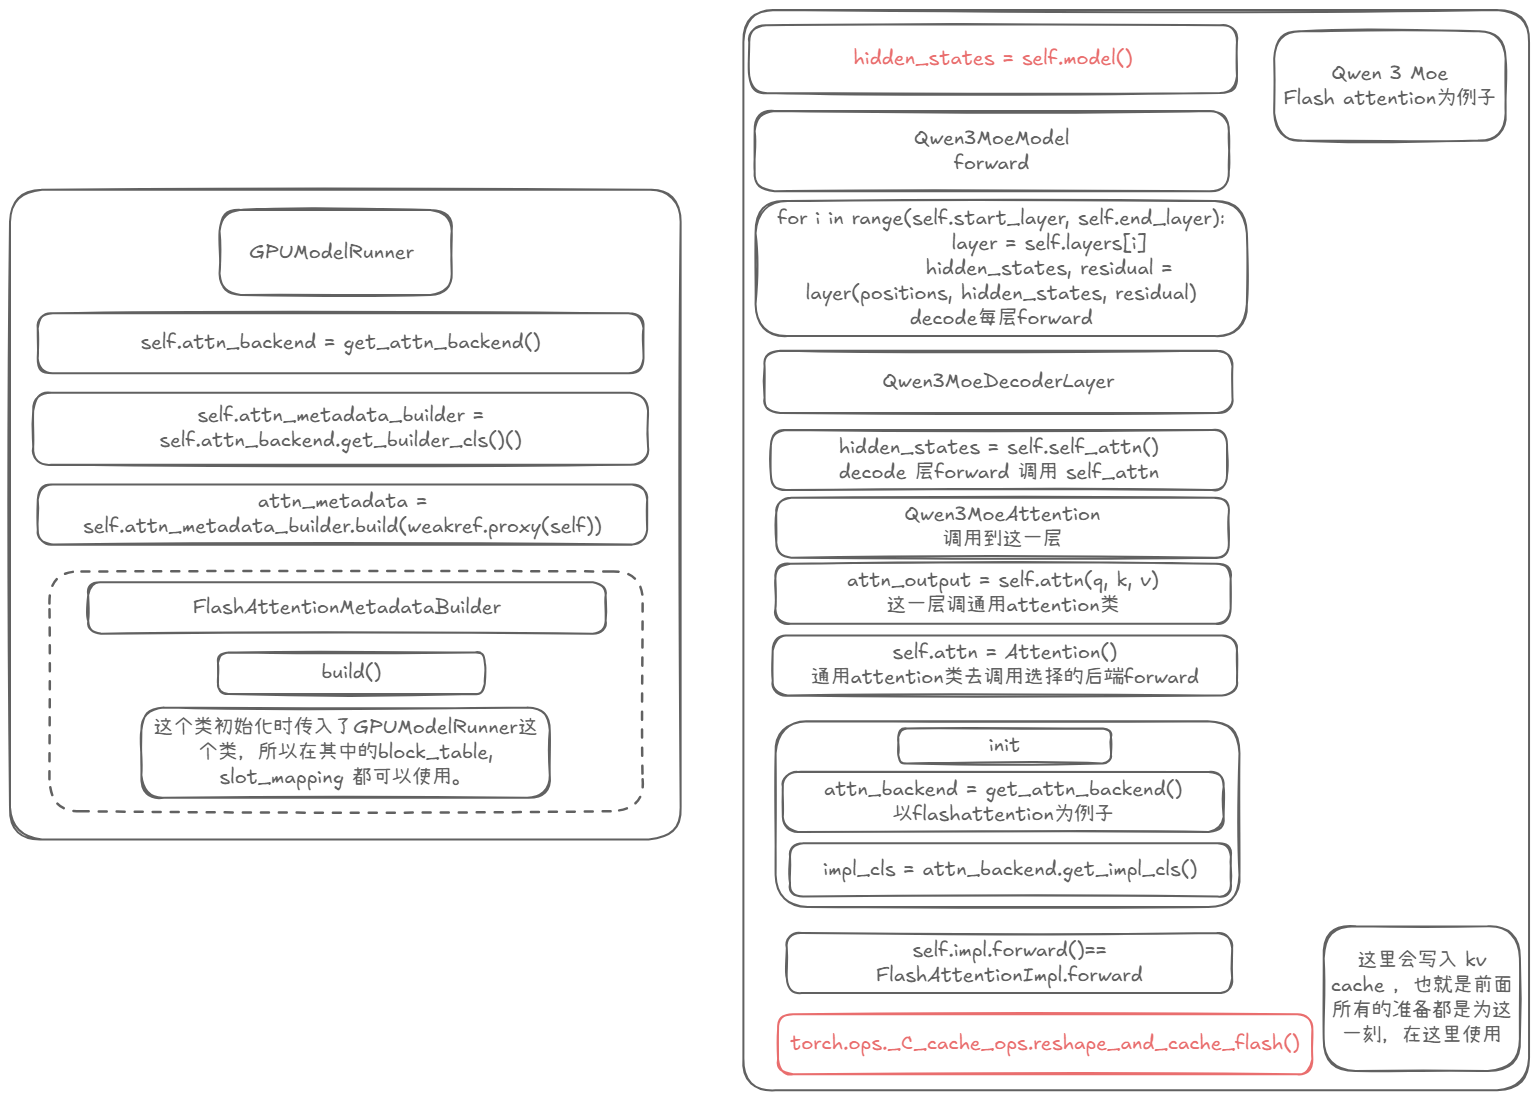
如图六,首先我们先解释刚刚的 attn_metadata 源码构造中好像并没有传入 slot_mapping,那他们是如何被模型使用的呢?
在图六左边中我们发现,GPUModelRunner 的 __init__ 时,调用了:
self.attn_backend = get_attn_backend()
self.attn_metadata_builder = self.attn_backend.get_builder_cls()(weakref.proxy(self))
这里的参数将 self(也就是 GPUModelRunner)传入,也就是为什么刚刚调用 build 函数时,我们可以获取 block_table、slot_mapping 这些数据。
然后我们以 Qwen3 MoE Flash Attention 为 backend 举一个例子,详细描述最后在哪里使用 block_table、slot_mapping 的。
当调用 Qwen3 MoE 模型的 forward 时,首先将调用每一层 Qwen3MoeDecoderLayer 的 forward,然后再到 Qwen3MoeAttention 的:
attn_output = self.attn(q, k, v)
但是这里的 self 是 Attention 类,而 Attention 类又会在 __init__ 时选择后端,也就是调用:
Attention 类的 forward == self.impl.forward() == FlashAttentionImpl.forward
我们在 flash attn 的 forward 中可以看到:
torch.ops._C_cache_ops.reshape_and_cache_flash()
这么一个函数,也就是它最后在使用 block_table 和 slot_mapping!他的源文件是用 CUDA 写的。
涉及文件:
gpu_model_runner.py、flash_attn.py、qwen3_moe.py、layer.py